← 全日スライド2026.09.29 / No.423(暫定) / SONNET 5.5 × EFFORT
今日の深掘り — Sonnet 5.5の「安さ」を、努力量で読む

CLAUDE SONNET 5.5 × COST PER TASK × EFFORT

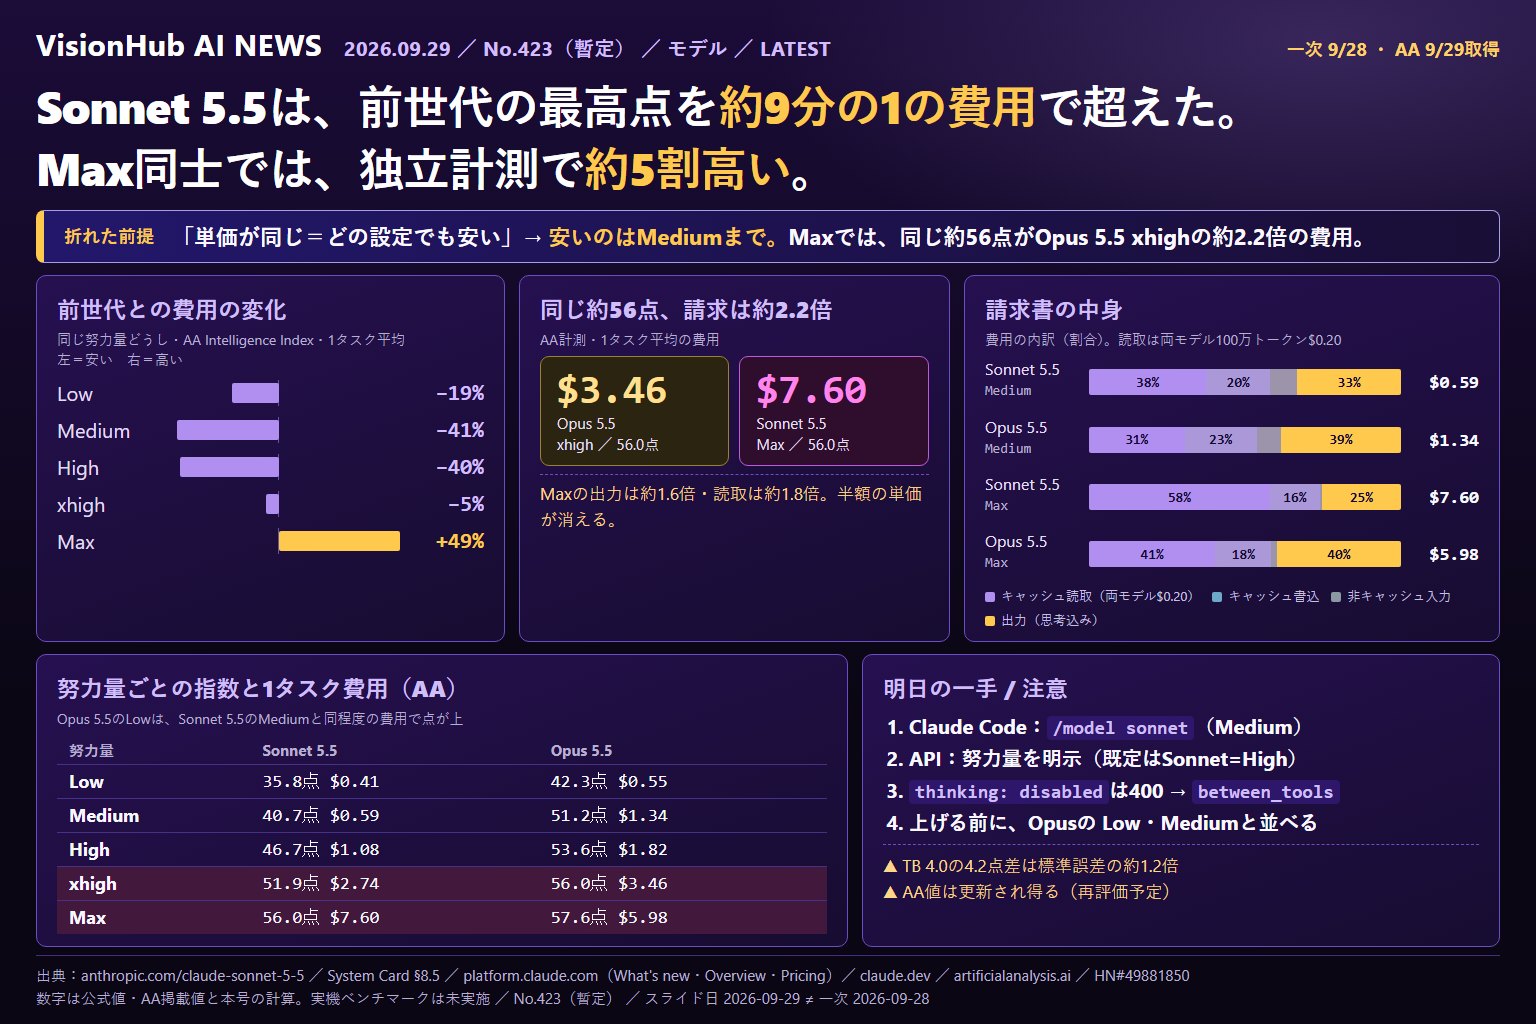
Sonnet 5.5は、前世代の最高点を約9分の1の費用で超えた。
Max同士では、独立計測で約5割高い。分かれ目は努力量(effort)。同じ約56点を、Opus 5.5のxhighは$3.46、Sonnet 5.5のMaxは$7.60で出した。

独立計測(Artificial Analysis)では、Sonnet 5.5はMediumで前世代の最高点を超え、費用は約9分の1で済んだ。ところが努力量を上げるほど前世代との差は縮み、xhighでほぼ並び、Maxでは逆転する。Maxの出力トークンは、前世代とOpus 5.5のどちらの約1.6倍。単価が同じでも、請求は「どの努力量で、何トークン使ったか」で決まる。最初はMedium。上げる前に、Opusの低い努力量と自分のタスクで比べる。

単価は前世代と同じ:入力$2・出力$10AAの値は2026/09/29取得(再評価予定)今日の判断:Mediumで始め、上げる前にOpusの低い努力量と比べる

一次情報:公式発表 [1] / システムカード [2] / 公式ドキュメント [3] / 独立計測 AA [7]
対象ニュース:2026/09/28発表 / 調査・確認:2026/09/29。公式の主張・独立計測・コミュニティの声を混ぜない。

約1/9
前世代の最高点を超える費用Sonnet 5.5のMediumで(AA計測)
+49%
Max同士の1タスク費用Sonnet 5との比較(AA計測)
$0.20
キャッシュ読取の単価Sonnet 5.5もOpus 5.5も同額
Medium
最初に置く努力量Claude Codeのsonnetの既定
1.5% / 10%
TB 4.0でフォールバックが入った試行Sonnet 5.5 / Opus 5.5

ONE-PAGE BRIEF / 1枚ボード

VISIONHUB / ONE-PAGE BRIEF2026.09.29

Sonnet 5.5の「安さ」は、
努力量の低い側にある。

単価は前世代と同じ。1タスクの費用は、努力量を上げるほど前世代との差が縮み、Maxで逆転する。
同じ約56点なら、Opus 5.5のxhighのほうが安い。

01 / COST CHANGE VS SONNET 5 — SAME EFFORT NAME

Low−19%
Medium−41%
High−40%
xhigh−5%
Max+49%

AA Intelligence Index・1タスク平均。左=安い、右=高い。

02 / SAME SCORE, DIFFERENT BILL — AA

$3.46Opus 5.5 / xhighIndex 56.0
$7.60Sonnet 5.5 / MaxIndex 56.0
半額なのは出力・入力・書込読取は両モデル$0.20
単価 ≠ 請求
ベンチ1本 ≠ 優劣

Maxでは出力が約1.6倍、読取が約1.8倍。半額の単価が消える。
Terminal-Bench 4.0の4.2点差は、標準誤差の約1.2倍。
最初はMedium。上げる前に、Opusの低い努力量と並べる。

費用を読む

努力量と比較基準を添える。
同じ名前でも中身が再調整済み。

仕事で振り分ける

仕様と検証手段があるならSonnet。
判断が続く仕事はOpus。

移行を先に潰す

thinkingの無効化・強制tool_choice・
履歴の編集は、そのままでは動かない。

出典:[1] 公式発表 / [2] システムカード / [3] ドキュメント / [7] AA。計算・構成は本号。SOURCES CHECKED 2026.09.29

本号による図解。数値は公式発表・システムカード・AAの掲載値、および本号の計算(費用変化率・埋めた割合など)です。AAの値は更新され得ます。文字と図はHTML内に収録しています。共有用1枚ボード:images/0929/cover.jpg(編集概念図)。

読み分け:公式発表・公式資料はAnthropicの主張と仕様。独立計測はArtificial Analysis(AA)の値。コミュニティの声はHNの個人投稿で、未検証。本号の解説・提案は計算と業務への応用案です。本号でモデルの実機ベンチマークは行っていません。

COST PER TASK, NOT PRICE PER TOKEN

「9分の1」と「5割増し」は、同じ表の両端にある

公式発表・公式資料独立計測(AA)本号の解説・提案単価は同じ。1タスクの費用は、努力量ごとに別の数字になる

Sonnet 5.5の単価は前世代と同じ、入力$2・出力$10(100万トークン当たり)。公式は「同じ仕事に必要なトークンが大幅に少ないので、1タスクの費用は最大30%下がる」と説明する。[1][3]では実際の請求はどうなるか。独立評価機関のArtificial Analysis(AA)は、Sonnet 5.5・Sonnet 5・Opus 5.5を5段階の努力量(Low〜Max)すべてで同じスイートにかけ、1タスクの費用を公開している。[7]

同じ努力量の名前どうしで並べた Sonnet 5.5 と Sonnet 5(AA Intelligence Index・1タスク平均)
努力量Sonnet 5
指数 / 費用
Sonnet 5.5
指数 / 費用
指数の差1タスクの費用の変化
Low24.3点 / $0.5135.8点 / $0.41+11.6
−19%
Medium28.1点 / $1.0040.7点 / $0.59+12.7
−41%
High31.7点 / $1.7946.7点 / $1.08+15.1
−40%
xhigh34.4点 / $2.8751.9点 / $2.74+17.5
−5%
Max38.2点 / $5.0956.0点 / $7.60+17.8
+49%

小さい画面では表を横にスクロールできます。

MEDIUM VS SONNET 5 MAX前世代の最高点を、約9分の1で

約1/9

Sonnet 5.5のMedium(40.7点・$0.59)が、Sonnet 5の最高点(Max・38.2点・$5.09)を超えた。費用は11.5%。公式の「最高点を約10分の1の費用で超える」とも整合する。[1]

MAX VS MAX同じMax設定では、逆転する

+49%

$5.09 → $7.60。指数は+17.8点伸びたが、出力トークンは約1.6倍(118k → 193k)。公式も、高い設定ではOpus 5.5と同程度の費用になり得ると書く。[1]

「最大30%安い」「約10分の1」「約5割高い」は、矛盾しない。
比べる基準が違う。同じ努力量の名前どうしか、同じ得点どうしか。努力量と比較基準を添えない費用の数字は、そのまま信じない。

AAのIntelligence Index(複数の評価を合成した指数)での1タスク平均。値はAAのモデルページ掲載値を2026/09/29に取得し、9/28の記事の公表値(Max:56点・$7.60・約19.3万出力トークン)と一致することを確認した。AAは事前提供版の不具合を理由に再評価を予告しており、値は更新され得る。誤差幅は示されていないため、1〜2点差は同点として扱う。公式は、努力量の意味がSonnet 5から再調整されているとも述べる。[3][7]

出典:公式発表 [1] / 公式ドキュメント [3] / AA記事・モデルページ [7]。費用変化率と「約9分の1」の計算は本号。

70.6% = MAX EFFORT × 66 TASKS

Terminal-Bench 4.0:「Opusを抜いた」は、誤差と条件つき

公式発表・公式資料独立計測(AA)条件・限界に注意見出しの4.2点差は、標準誤差の範囲に近い

公式発表の8項目のうち、Sonnet 5.5がOpus 5.5を上回ったのはTerminal-Bench 4.0だけ(70.6%対66.4%)。[1]システムカードは、この数字の条件を細かく書いている。[2]

Terminal-Bench 4.0(システムカード §8.5)。棒は平均、白い線は標準誤差(公表はSonnet 5.5とOpus 5.5のみ)。他のモデルの標準誤差は±1.6〜2点。
Sonnet 5.5max(公式の測定条件)70.6%
Opus 5.5xhigh(同社カードの報告値)66.4%
Opus 5.5max64.8%
Mythos 5.160.9%
Fable 5.155.8%
Opus 552.3%
Sonnet 5前世代10.3%

SAMPLE SIZE66タスク × 5試行

タスクは66件、各5回試行して平均(Sonnet 5.5とOpus 5.5は330試行)。標準誤差は±2.5点と±2.6点。差の4.2点は、誤差の合成幅(約±3.6点)の約1.2倍で、優位とは言い切れない。[2]

EFFORT努力量が違う

Sonnet 5.5はmax、Opus 5.5はxhighの報告値(maxでは64.8%)。Claude Codeの--bareモードで測った値で、普段の使い方の点数ではない。[2]

SAFEGUARD FALLBACK安全策で別モデルが答えた

安全策に触れて別モデル(Sonnet 5)が答えた試行は、Sonnet 5.5が1.5%、Opus 5.5が10%。Sonnet 5の同ベンチは10%台なので、Opus側が不利になった可能性がある(本号の推測)。[2]

独立計測のAAでも向きは同じで、Sonnet 5.5が63.6%、Opus 5.5が59.6%(どちらもMax)。ただしAAの値も66タスク規模で、誤差幅は示されていない。[7]フォールバック率の違いはHNで指摘されたもので、システムカードで裏を取った。[8][2]

本当のニュースは、順位ではなく跳躍。
前世代のSonnet 5は、AAのMaxで14.1%、公式の表で10.3%。Sonnet 5.5との差は、AAの独立計測でも約49点ある。

安全策のフォールバックは、AAのIndex全体では約0.1%のタスクにとどまり、主にTerminal-Bench 4.0で起きた。[7]セキュリティ寄りの端末作業ほど、点数の内訳に安全策が効く。TB 4.0の66タスクは計算生物学・物理シミュレーション・CAD・形式証明・GPU性能などの高難度が中心で、日常の開発作業の代表ではない。[2]

出典:システムカード §8.5 [2] / 公式発表の比較表 [1] / AA [7] / HNの指摘 [8]。差と標準誤差の比の計算は本号。

GAP CLOSED, SONNET 5 → OPUS 5.5

8項目の地図:縮まったのは実務系、残ったのは知識と科学

公式発表・公式資料独立計測(AA)本号の解説・提案公式の表を、前世代からOpus 5.5までの差をどこまで埋めたかに並べ直した

公式発表の表を、Sonnet 5.5がSonnet 5からOpus 5.5までの差をどこまで埋めたかで並べ直した。100%はOpus 5.5と同点。[1]

埋めた割合 =(Sonnet 5.5 − Sonnet 5)÷(Opus 5.5 − Sonnet 5)。縦線が100%(Opus 5.5と同点)。公式発表の表[1]から本号が計算。
Terminal-Bench 4.010.3% → 70.6%(Opus 5.5 66.4%)107%
FrontierCode 1.1(Max)42.4% → 46.2%(Opus 5.5 54.4%)32%
FrontierCode 1.1(Xhigh)42.4% → 52.1%(Opus 5.5 54.4%)81%
CursorBench 4.034.1% → 55.5%(Opus 5.5 57.8%)90%
GDPval-AA v2.11449 → 1844(Opus 5.5 1846)99%
AA-Briefcase v1.11359 → 1811(Opus 5.5 1822)98%
Humanity's Last Exam(ツールあり)54.9% → 64.5%(Opus 5.5 67.7%)75%
OSWorld 2.1(partial)57% → 80.1%(Opus 5.5 81.8%)93%
Chartography(ツールなし)15.6% → 61.6%(Opus 5.5 64.4%)94%

GDPval-AA・AA-Briefcase・OSWorld・Chartography・CursorBenchでは、約9〜10割まで埋めた。埋まりきっていないのは、HLE(75%)と、FrontierCodeのMax(32%)。FrontierCodeはXhighなら81%で、Maxのほうが低い理由は第4章で扱う。

AAが測った、Sonnet 5.5とOpus 5.5の差(どちらもMax・AA自身の指標)
指標Sonnet 5.5Opus 5.5読みどころ
Terminal-Bench 4.063.6%59.6%Sonnet 5.5が上(条件は第2章)
AutomationBench-AA71.3%69.5%Sonnet 5.5が上(差は小さい)
GDPval-AA18441846ほぼ同点
AA-Omniscience
事実の正解率
53.9%66.2%Opusが上。差が最大の項目
AA-Omniscience
幻覚率(低いほど良い)
47.0%58.6%Sonnet 5.5が低い
Humanity's Last Exam55.0%61.4%Opusが上
SciCode61.0%66.9%Opusが上
Terminal-Bench-Science53.3%59.0%Opusが上

小さい画面では表を横にスクロールできます。

この章の数字には、公式が付けた注記がある。
AAの評価は事前提供版(構造化出力の応答が劣化し得る不具合つき)で実施された。公式は、影響は小さいか、Sonnet 5.5をむしろ低く見積もる方向だと見込む(修正済み・AAが再評価予定)。GPT-6 Solとの比較は、OpenAIが画像理解の不具合を直した直後で、AAやSurge AIの値が最新版を反映していない可能性がある。Terminal-BenchとCursorBenchでは、GPT-6 Solの値が未公表のためGPT-5.6 Solが図示されている。[1]

出典:公式発表の比較表と脚注 [1] / AAモデルページ(2026/09/29取得)[7]。埋めた割合の計算は本号。

THE EFFORT DIAL

努力量ダイヤル:Sonnet 5.5の得意な席は、Lowの隣にある

公式発表・公式資料独立計測(AA)コミュニティの声(未検証)既定値は面ごとに違う。上げるほど得点も費用も増える

努力量(effort)は、思考の深さ・所要時間・費用をまとめて動かすダイヤルで、Low・Medium・High・xhigh・Maxの5段階。既定値は面ごとに違う。Claude CodeのsonnetはMedium、APIのSonnet 5.5はHigh。一方、Opus 5.5のAPI既定はmedium。モデルIDだけ差し替えると、Sonnet側の努力量が1段上がる。[4][6]

努力量ごとの費用と得点(AA Intelligence Index)横軸は1タスクの費用の対数、縦軸はAA Intelligence Index。Sonnet 5.5のLowは最も安い点。Opus 5.5のxhighは56.0点を$3.46で、Sonnet 5.5のMaxは56.0点を$7.60で出す。2030405060$0.5$1$2$5$101タスクの費用(USD・対数目盛)→ 右ほど高いAA Intelligence Index → 上ほど高得点56同じ約56点を出す費用:Opus 5.5 xhigh $3.46、Sonnet 5.5 Max $7.60LowMaxLowMediumHighxhighMax $7.60LowMediumHighxhigh $3.46MaxSonnet 5.5Opus 5.5Sonnet 5(前世代)
AAの計測から読み取れる、4つの位置関係(Intelligence Index・1タスク平均)
比べるもの数字読み
Sonnet 5.5 Low35.8点 / $0.41比べた15設定の中で最も安い点。Opus 5.5の最安(Low・$0.55)より安い
Opus 5.5 Low
対 Sonnet 5.5 Medium
42.3点 / $0.55
40.7点 / $0.59
費用は同程度で、点はOpusが上
Opus 5.5 High
対 Sonnet 5.5 xhigh
53.6点 / $1.82
51.9点 / $2.74
Opusのほうが安く、点も上
約56点を出す費用Opus xhigh:$3.46
Sonnet Max:$7.60
Sonnet 5.5のMaxは、Opus 5.5のxhighの約2.2倍

小さい画面では表と図を横にスクロールできます。

AAも、Sonnet 5.5は費用と知能のパレート最前線の外にあると述べる。[7]公式も、Opus 5.5を補うのは低い努力量のときで、高い設定では同程度の費用になる、と書く。[1]

AGENTIC CODING多段の作業

仕様が明確ならMediumから。難しい・長い仕事はHighへ。[3][6]

CHAT / LOW LATENCYチャット・低遅延

MediumかLowから。[3][6]

XHIGH / MAX最上位の2段

評価で得点が伸びる仕事だけ。[6]

努力量の意味はSonnet 5から再調整されており、設定は持ち越さずスイープをやり直す。システムプロンプトで「あまり考えないで」と頼んでも思考量は確実には減らないので、下げたいときは努力量を下げる。努力量を途中で変えるとプロンプトキャッシュが無効になる。1ターンだけ変えるなら、キャッシュを保つper-message effort(ベータ)を使う。between_toolsはLow〜Highでのみ使える。[3][6]

Maxは、費用だけでなく失敗も増える。
公式のFrontierCode脚注では、MaxがXhighより低い(46.2%対52.1%)。Maxではコードレビュー用のスキルを多く走らせ、多数のサブエージェントに分割したため、タイムアウトや範囲外の編集が起き、「人の手直しなしでマージできるか」の採点で減点された。[1]

HNに投稿された個人の1回の実験(同じ1つの依頼・未検証)
努力量所要時間費用思考トークン
Low10秒1.6セント0
Medium11秒1.8セント0
High17秒2.3セント745
xhigh42秒5.7セント2,535
Max15分40秒$1.28128,000(回答が返らず)

HN投稿者 simonw の報告。n=1で、依頼の種類(SVGの絵)も限られるため、傾向の一例にとどまる。Lowでは費用が約1.6セント、Maxでは思考だけで上限の128,000トークンを使い切った。[8]

出典:モデル概要の比較表 [4] / 開発者向けガイド [6] / 公式ドキュメント [3] / AA [7] / 公式発表の脚注 [1] / HN [8]。位置関係の読みは本号。

WHAT THE BILL IS MADE OF

請求書の中身:半額なのは出力と入力。大半を占める読取は同額

公式発表・公式資料独立計測(AA)本号の解説・提案公開単価とAAの費用内訳からの概算。実際の請求は契約や割引で変わる

公開単価は次のとおり。Sonnet 5.5は入力・出力・キャッシュ書込がOpus 5.5の半額。ただしキャッシュ読取だけは、どちらも100万トークン$0.20で同額。[5][6]

100万トークン当たりの単価(USD)
項目Sonnet 5.5Opus 5.5比
入力$2$4半額
出力$10$20半額
キャッシュ書込(5分)$2.50$5半額
キャッシュ書込(1時間)$4$8半額
キャッシュ読取$0.20$0.20同額

バッチ処理は入出力とも50%引き。米国内限定の推論(inference_geo: "us")は全項目が1.1倍。1Mトークンのコンテキストは標準単価で、長文の割増はない。高速モードはOpusのみで、Sonnet 5.5にはない。[5][6]

エージェント型のタスクは毎ターン過去の文脈を読み直すので、請求の主役は「読取」になる。AAの内訳では、Sonnet 5.5のMaxは1タスクで約22.1Mトークンをキャッシュから読み、費用の58%($4.41)を占めた。Lowでも35%。

1タスクの費用の内訳(AA Intelligence Index・割合)。右端は1タスクの合計費用。AAの費用内訳を掲載値のまま使用。
Sonnet 5.5Medium38%20%33%$0.59
Opus 5.5Medium31%23%39%$1.34
Sonnet 5.5Max58%16%25%$7.60
Opus 5.5Max41%18%40%$5.98
キャッシュ読取(両モデル$0.20)キャッシュ書込非キャッシュ入力出力(思考込み)

Maxでは、Sonnet 5.5の出力トークンはOpus 5.5の約1.6倍、キャッシュ読取は約1.8倍(22.1M対12.1M)。出力単価が半額でも、読取は同額のまま量だけ増えるため、1タスクの費用は逆にSonnet 5.5が1.27倍になった。Mediumでは0.44倍で、安さが効いている。[7]

1タスクの費用を、公開単価で再構成する

AAの費用内訳を単価で割り戻した概算 / USD
1タスクあたりSonnet 5.5Opus 5.5

単価(100万トークン当たり・Sonnet 5.5/Opus 5.5):読取 $0.20/$0.20 ・ 書込(5分)$2.50/$5 ・ 入力 $2/$4 ・ 出力 $10/$20

Sonnet 5.5——
Opus 5.5——
Sonnet 5.5 ÷ Opus 5.5——

各行は「AAのIntelligence Indexで、1タスクが平均して使ったトークン量」を、AAの費用内訳を公開単価で割り戻して再構成した値。プリセットを選ぶと、AAの1タスク費用を再現する。自分の値に書き換えれば、単価差とトークン量のどちらが効くかを試せる。バッチ・地域指定・キャッシュの有効期間の違いは含めない。入力値の外部送信は行わない。[5][7]

「半額」が効くのは、出力・入力・書込。
読取が主役の仕事では、トークン量の差がそのまま請求の差になる。見積もりは、自社の実トークン(読取・書込・出力)で作る。

画像を渡す場合は、高解像度枠(長辺2,576ピクセルまで)が使われ、2000×1500の画像はSonnet 4.6などの約2.5倍のトークンになる。不要な解像度は送る前に縮小する。[6]

出典:料金ページ [5] / 開発者向けガイド [6] / AAの費用内訳(モデルページ・2026/09/29取得)[7]。トークン量の割り戻し・比率の計算は本号。

SPEC + VERIFIER → SONNET / JUDGMENT → OPUS

仕様と検証手段がある仕事から、Sonnetへ

公式発表・公式資料コミュニティの声(未検証)本号の解説・提案導入企業の声は、公式発表に載った自己申告

公式の使い分けは明快。Sonnet 5.5が向くのは、仕様が決まっていて、結果を確かめる手段がある仕事。長く判断し続ける仕事と最難関の問題は、Opus 5.5。[1][6]

公式ガイドの使い分け(最初に選ぶモデル)
仕事最初に選ぶモデル
バグ修正・機能の素早い反復・要件に照らした検証Sonnet 5.5
大量の日常的な開発Sonnet 5.5
文書・スライド・表計算(デザインの目が効く仕事)Sonnet 5.5
繰り返し回す、決まったエージェント作業(調査・レビュー・下書き)Sonnet 5.5
判断が要る複雑な仕事(長期のエージェント型コーディング・知識労働)Opus 5.5
最も難しい問題Opus 5.5

小さい画面では表を横にスクロールできます。

CODERABBIT単純〜中程度のレビューから移す

Sonnet 5で多かったWeb検索の使いすぎと高いトークン消費が、新モデルでは解消したという。数週間かけて対象を広げる予定。[1]

CREATOROpusが設計、Sonnetが実装

Opus 5.5がゲームの構成を決めるなら、実装はSonnet 5.5に任せて安心できるという評価。[1]

BASE44118件のアプリ構築

Opus 5と同水準のスコアに、平均3.6反復で到達(Opus 5は7.7反復)。比較対象はOpus 5で、Opus 5.5ではない。[1]

BALYASNY2,441件の金融タスク

1回答あたり約12.1万トークン(Sonnet 5は約49.7万)。試した7モデルの中で、品質と費用のバランスが最良と報告。[1]

導入企業の声は公式発表に掲載された自己申告で、タスクの内容・努力量・比較対象は各社で違う。数字は「その環境での例」として読む。[1]

設計はOpus、実装はSonnet。この構成は、公式にも用意されている。
advisorツール(ベータ)では、Sonnet 5.5を実行役、Opus 5.5などをアドバイザーにできる。アドバイスは暗号化されて返り、クライアントは中身を読めない。Opus 4.8・4.7・Sonnet 5はアドバイザーにできない。[3]

CLAUDE CODE切り替え方

sonnetエイリアスがSonnet 5.5になる(v2.1.284以降)。Mediumが既定で、思考のオフと高速モードはない。既定モデルはOpus 5.5のままなので、/model sonnetで切り替える。[6]

HN の温度感評価は割れる

「HighやxhighのSonnetより、Opusの低い努力量でよいのでは」という指摘が多く、AAの結果と符合する。一方で、独自の難問ベンチが前世代の17.8%から7.4%に下がり、途中でユーザーに確認を返しがちという個人の報告もある。Base44の「途中で止まることが少ない」とは逆で、タスクにより割れる。[8]

本号の提案:仕事の形で振り分ける(最初の仮説。自社の評価で更新する)
仕事の形最初の選択理由
仕様とテストが揃った修正・機能追加Sonnet 5.5 / Medium費用が小さく、テストで誤りを拾える
要件が曖昧・設計判断を含むOpus 5.5 / Medium〜High判断を続ける力が要る
長時間・多段の自律作業Opus 5.5(実行役にSonnet)Maxに上げるより、役割を分ける
資料・スライドの下書きSonnet 5.5 / Medium速さと仕上がり。数字は別に検算
事実知識・科学推論が中心Opus 5.5AA-OmniscienceやHLEで差が残る
大量・定型で、とにかく安くSonnet 5.5 / Low最安の席。より軽いHaiku 5.5は数週間後

出典:公式発表 [1] / 開発者向けガイド [6] / 公式ドキュメント(advisorツール)[3] / HN [8]。振り分けの提案は本号。

DOCS, SLIDES & SPREADSHEETS

資料づくり:下書きは速く、数字は別の目で

公式発表・公式資料独立計測(AA)条件・限界に注意「そのまま送れる」は、公式の社内テストでの専門家の評価

公式が前面に出すのは、文書・スライド・表計算の仕上がりと、デザインの目。テンプレートに沿って、ほとんど手直しのいらないスライドを作れるという。社内テストでは、上場企業の決算資料と通話記録にスライドテンプレートを添えて、10枚の業績レビューを依頼。専門家2人が、初稿をそのまま送れると判断した。[1]

知識労働・PC操作・図表認識の指標(公式発表の表)
指標Sonnet 5.5Opus 5.5Sonnet 5
GDPval-AA v2.1(44職種)184418461449
AA-Briefcase v1.1(長期の知識労働)181118221359
OSWorld 2.1(PC操作・partial)80.1%81.8%57.0%
Chartography(図表認識)61.6%64.4%15.6%

小さい画面では表を横にスクロールできます。

BOX原資料の再確認

原資料でデータを確かめ、Sonnet 5が見落とした誤りを拾ったという。精度が上がり、2.4倍速く、総トークンは12%減。[1]

ZENDESKサポート対応

数百件の実例で、本番で使っているClaudeモデルより誤った判断が少なく、チケット処理が20%速いという。[1]

SLACKSlackbot

プロンプトを変えずに、ほぼ全ての社内評価で前世代を上回り、出力トークンは約14%減という。[1]

事実の正確さは、Opusが上。
AA-Omniscienceの事実の正解率は53.9%対66.2%(Maxどうし)。知らないときに外す率(幻覚率)は47.0%対58.6%で、Sonnet 5.5のほうが低い。数字・固有名詞・日付は、必ず原資料と突き合わせる。[7]

本号の提案:資料づくりの型
①テンプレートと原資料を先に渡す。②数字は、原資料の該当箇所とセットで出させる。③出典と数値の検算は、スクリプトか別のモデルで機械的に行う。④「そのまま送れる」は、専門家が確認してから。

AAのGDPval-AAとAA-Briefcaseは、事前提供版の不具合を含む環境での測定。公式は、影響は小さいか、Sonnet 5.5の性能をむしろ低く見積もる方向だと見込む。[1]本号の数値も、一次資料とAAの掲載値から計算スクリプトで検算している。

出典:公式発表 [1] / AA [7]。資料づくりの型は本号の提案。

SAFEGUARDS, FALLBACK & REFUSALS

安全策:断られたとき、APIでは何が返るか

公式発表・公式資料独立計測(AA)コミュニティの声(未検証)通常の開発への影響は小さい。ただし、断られる経路は実装しておく

Sonnet 5.5は、Sonnetとして初めて、サイバー安全策つきで出た。ソースコード中の脆弱性発見は許可、コンパイル済みバイナリの脆弱性発見は遮断、という線引きはOpus 5.5と同じ。[2]遮断された依頼は、Anthropic自身のアプリでは自動でSonnet 5に切り替わる。APIでは、開発者が自動フォールバックにオプトインする必要がある。[2][3]

断られたときの分類(stop_details)とフォールバック
分類意味Sonnet 5へのフォールバック
cyberサイバー被害につながり得る依頼あり
frontier_llm競合AIモデルの開発を助け得る依頼(ごく限られた領域)あり
bio生物学的な被害につながり得る依頼なし
reasoning_extraction内部の推論を応答文に再現させる依頼なし
general_harmsその他の利用規約の領域なし

小さい画面では表を横にスクロールできます。

APIでは、断られた依頼はHTTP 200でstop_reason: "refusal"とstop_detailsが返る。自動フォールバック(fallbacks: "default"・ベータ)はcyberとfrontier_llmだけをSonnet 5で再試行し、残りの3種は再試行しない。断られた依頼が課金されるかは分類次第で、レート制限には数えられる。[3]

FREQUENCYどれくらい起きるか

AAは、Index全体の約0.1%のタスクでSonnet 5へのフォールバックを観測し、主にTerminal-Bench 4.0だった。[7]システムカードでは、TB 4.0の試行の1.5%(Opus 5.5は10%)。[2]HNには、Cyber Verification Programの参加者が認可済みの報奨金作業でもcyber判定を受けたという投稿がある(未検証)。[8]

PROGRAMS正当な業務のために

セキュリティ業務向けには、遮断を縮小するCyber Verification Programが拡張される。Sonnet 5.5への対応は「近く」とされ、9/28時点では申請の案内待ち。生物分野にはLife Sciences Verification Programがある。微生物学・ウイルス学の一部の依頼は、誤って止まることがある。[1][2]

DISTILLATION推論の持ち出し

推論の抽出を狙う依頼は、フォールバックなしでブロックされる。思考ブロックは作成したアカウントに結び付き、別アカウントから送ると、読まれずに捨てられる(リクエストは成功する)。Claude Codeで途中でアカウントを切り替える場合も影響する。[1][3]

IMPROVED良くなった点

プロンプトインジェクション耐性は前世代より改善(Gray Swan IPI・k=15で3.4%対6.7%)。Opus 5.5とFable 5.1よりは低い。際どいが正当な依頼の過剰拒否は、APIで0.02%(Sonnet 5は0.59%)。[2]

本号の提案:断られる経路を、先に作る。
①自動フォールバックを使うか、refusalを自前で処理するかを決める。②評価セットに「断られる」ケースを入れ、Sonnet 5に落ちたときの品質と費用を測る。③推論をそのまま書き出させる指示はreasoning_extractionを招くので、要約された思考(thinking.display: "summarized")を読む。[6]

出典:システムカード §1.5・§3・§4・§5 [2] / 公式ドキュメント [3] / 公式発表 [1] / AA [7] / 開発者向けガイド [6] / HN [8]。

MIGRATION CHECKLIST & DECISION

移行と導入判断:壊れる5つ、静かに変わる1つ、最初の1週間

公式発表・公式資料本号の解説・提案モデルIDの差し替えだけでは動かない。手順の正は公式の移行ガイド

Sonnet 5からの移行で、公式が挙げる破壊的変更は5つ。エラーにならず挙動だけが変わるものが1つある。[3]

Sonnet 5 → Sonnet 5.5:確認する変更
変更起きること対処
① thinkingの無効化thinking: {"type": "disabled"}が400エラーbetween_toolsに。Low〜Highのみ、他のフィールドは付けられず、会話の途中で努力量を変えられない
② 強制的なtool_choiceany・toolが400エラー(トークン計算も)autoにstrict: trueか構造化出力。使う場面はプロンプトで指示
③ 思考ブロックの結び付き履歴を編集して再送すると400エラー(2026/08/31以降に作成したアカウントは既定で検査)会話は追記のみ。指示やツールの変更は、途中のシステムメッセージで
④ computer useツールcomputer_20251124が400エラー(Claude API・Google Cloud)computer_toolset_20260801へ。Bedrockは旧ツールも可
⑤ advisorの組み合わせOpus 4.8・4.7・Sonnet 5をアドバイザーにすると400エラーOpus 5.5などに変更
⑥(静かな変更)ツール呼び出しの間のテキストがthinkingブロックで返り、表示が黙るthinking.displayを設定するか、between_toolsにする

小さい画面では表を横にスクロールできます。

このほか、temperature・top_p・top_kを既定以外にすると400エラー。[4]努力量の意味は再調整済みなので、Sonnet 5の設定を持ち越さず、スイープをやり直す。[3]

① thinkingを無効にしていたコードの移行例(Python)

# Before: Claude Sonnet 5
client.messages.create(
    model="claude-sonnet-5",
    max_tokens=16000,
    thinking={"type": "disabled"},
    output_config={"effort": "xhigh"},
    messages=[{"role": "user", "content": "..."}],
)
# After: Claude Sonnet 5.5(between_toolsはhigh以下)
client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=16000,
    thinking={"type": "between_tools"},
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "..."}],
)

② Claude Codeでの切り替えと一括移行

/model sonnet
/claude-api migrate this project to claude-sonnet-5-5

1行目はClaude Code v2.1.284以降のsonnetエイリアス(Medium既定)。2行目は同梱のClaude APIスキルがモデルIDの差し替えと破壊的変更の修正を一括で行う。どちらも変更は必ず差分で確認する。[6]

導入前チェック

このページを開いている間だけのチェック。保存・送信なし。0 / 7

Sonnet 5.5は、Opusの安い代用品ではない。

低い努力量で回す、仕様の決まった仕事の標準機。
上げるほど、安さは薄れる。Maxでは、単価の半額が消える。自分のタスクで「同じ成功率に必要な費用」を測ってから、切り替える範囲を決める。

破壊的変更は公式ドキュメント [3]・[4]、コード例と手順は開発者向けガイド [6]による。チェック項目と導入方針は本号の提案。

PRIMARY SOURCES & EDITORIAL NOTES

出典と、今回の確認範囲

  1. Anthropic — Introducing Claude Sonnet 5.5(2026/09/28) ↗公式発表。比較表・脚注・導入企業の声・単価・安全策・提供範囲。導入企業の声は自己申告。
  2. Anthropic — Claude Sonnet 5.5 System Card(PDF・2026/09/28) ↗§1.5 安全策、§4 過剰拒否、§5 プロンプトインジェクション、§8.5 Terminal-Bench 4.0(試行数・標準誤差・努力量・フォールバック率)。
  3. Claude Platform Docs — What's new in Claude Sonnet 5.5 ↗破壊的変更5件と静かな変更1件、努力量の推奨、安全策の分類とフォールバック、advisorツール、提供範囲。
  4. Claude Platform Docs — Claude Sonnet 5.5 overview ↗モデル比較表(既定の努力量:Sonnet 5.5はhigh、Opus 5.5はmedium)、コンテキスト、最大出力、temperature等の制約。
  5. Claude Platform Docs — Pricing ↗キャッシュ読取・書込の倍率、バッチ50%引き、米国内推論1.1倍、長文の割増なし、高速モードの対象。
  6. claude.dev — Building with Claude Sonnet 5.5(2026/09/28) ↗開発者向けの使い分けと移行の手引き(Anthropicの一人称で書かれたページ)。Claude Codeのエイリアス・既定モデル・画像トークン・1時間書込単価など、このページ固有の記載は同ページによる。
  7. Artificial Analysis — Claude Sonnet 5.5 記事(2026/09/28)/モデルページ ↗独立計測。努力量別の指数・1タスク費用・出力トークン・費用内訳はモデルページの掲載値(2026/09/29取得)。事前提供版の不具合により再評価予定。
  8. Hacker News — Sonnet 5.5(525ポイント・約350コメント) ↗コミュニティの議論。個人の意見・実験は、統制された比較とは区別。反応数は変動するため参考値。
  9. VisionHub — 2026年9月23日号(Opus 5.5とGPT-6 Sol) ↗関連号。Opus 5.5の単価・提供面の背景。本号の内容の根拠には使用していない。
編集上の注記
号数は No.423(暫定)。09/26号の暫定番号(No.422)に続けた。
2026/09/28に公開された一次情報を、2026/09/29に確認して編集。Artificial Analysisの数値はモデルページの掲載値を9/29に取得し、9/28の記事の公表値(Max:指数56・1タスク$7.60・約19.3万出力トークン・Terminal-Bench 4.0 約64%・GDPval-AA 1844)と一致することを確認した。AAは事前提供版の不具合を理由に再評価を予告しており、値は更新され得る。
本号で計算した値:費用の変化率、「約9分の1」、8項目の「埋めた割合」、差と標準誤差の比、AAの費用内訳を公開単価で割り戻したトークン量、Sonnet 5.5とOpus 5.5の比。いずれも公開値からの計算で、独自の実測ではない。
HNの個人投稿は統制された比較ではないため、性能の根拠には使わず、論点と例の紹介に限った。導入企業の声は公式発表に載った自己申告として扱った。
本文の表示と計算に、外部スクリプト・外部フォント・外部画像は使いません(サイト共通の計測スクリプトを除く)。計算機は画面内で完結し、入力値の送信は行いません。出典リンクを開く操作は外部サイトへの移動になります。