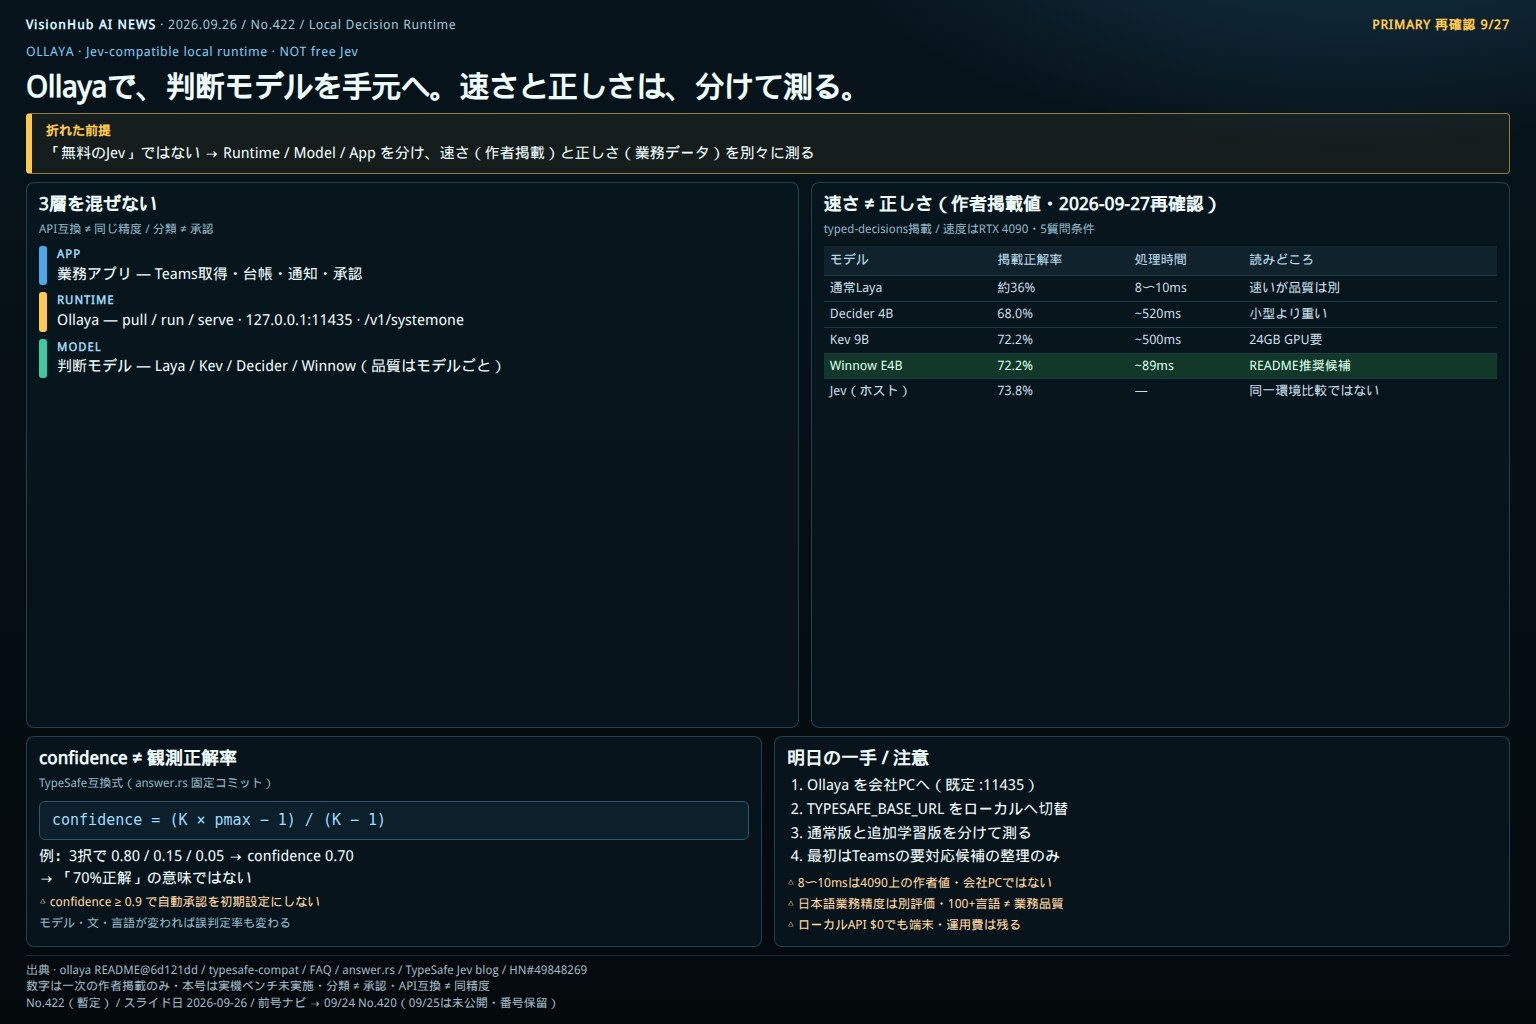
← 全日スライド2026.09.26 / No.422 / LOCAL DECISION RUNTIME
今日の深掘り — 判断モデルを、会社PCの中へ

OLLAYA × JEV-COMPATIBLE LOCAL RUNTIME

Jev互換のローカル実行基盤「Ollaya」判断モデルを、手元へ。
速さと正しさは、分けて測る。「無料のJev」ではなく、選んで動かすための共通基盤。

Ollamaのようにモデルを取得し、型付きの判断をローカルAPIで返す。新しさは、モデル精度そのものより導入・運用の手軽さにある。公開評価と実務の条件を分けて読み、最初はTeamsの要対応候補を整理する。承認や実行は、人が確認するところに残す。

TypeSafe API互換 / モデル品質は別ローカル推論 / 外部送信経路は別途確認今日の判断:まずは、見落とし防止の補助に

一次情報:公式README [1] / TypeSafe互換仕様 [2] / 公式FAQ [3]
対象ニュース:2026/09/26号 / 調査・再確認:2026/09/27。後日確認した仕様・数値を、当日時点の実測や確定値と混同しない。

11435
ローカルAPIの既定ポートTypeSafe互換の呼び出し口
8〜10ms
Layaの作者掲載値RTX 4090 / 5質問の条件
100+
多言語モデルの対象言語日本語の業務精度は別に評価
API $0
ローカル推論の従量課金端末・管理・運用費は残る
人が承認
最初の業務設計分類候補を示し、実行は分離

ONE-PAGE BRIEF / 1枚ボード

VISIONHUB / ONE-PAGE BRIEF2026.09.26

Ollayaは、判断モデルの
「選んで、動かす」をそろえる。

文章を書くAIではなく、定義した選択肢を返すモデルをローカルへ。
新しさは運用の手軽さ。判断の正しさは、モデルと業務データで別に確かめる。

01 / THREE DIFFERENT LAYERS

業務アプリTeams取得・台帳・通知・承認
Ollayaモデル取得 + ローカルサーバー + 共通API127.0.0.1:11435 / v1/systemone
pullrunserveMCP
判断モデルLaya / Kev / Decider / Winnow

02 / TYPED DECISION — ILLUSTRATION

架空の出力例 / 実測ではない
「来週の反映に向けて、変更内容を
確認していただけますか?」
要対応
0.80
共有のみ
0.15
その他
0.05

この3択では confidence = 0.70。
ただし「70%正解」の意味ではない。

分類 ≠ 承認
API互換 ≠ 同じ精度

返金要求を見つけても、返金してよいとは限らない。
同じ形式で呼べても、同じ品質にはならない。
最初は原文と候補を示し、実行は人が確認する。

速さを読む

「8〜10ms」は4090上の作者値。
会社PCの体感ではない。

品質を読む

通常版と追加学習版を分ける。
日本語の条件・否定・訂正を試す。

導入を決める

見逃しを増やさず、手間を減らす。
迷ったら、要確認へ戻す。

出典:[1] README / [2] 互換仕様 / [3] FAQ / [5] confidence実装。構成は本号の解説。PRIMARY SOURCES CHECKED 2026.09.27

本号による図解。架空の分類出力を含む説明用の模式図で、実際のモデルの推論結果ではありません。公式の機能・測定値は[1]〜[3]、confidenceの式は[5]に基づきます。文字と図はHTML内に収録しています。共有用1枚ボード:images/0926/cover.jpg(編集概念図)。

読み分け:公式仕様・公開資料は掲載内容の確認。条件・限界は適用範囲。本号の解説・提案は業務への応用案です。本号でモデルの実機ベンチマークは行っていません。

RUNTIME ≠ MODEL ≠ BUSINESS AUTHORITY

Ollayaは「ローカルのJev」ではなく、判断モデルの共通基盤

公式仕様・公開資料本号の解説・提案同じAPIで呼べることと、同じ答えが出ることは別

Ollayaは、オープンな判断モデルを名前で取得し、ローカルのHTTP APIとして提供する実行基盤。pull / run / serveをそろえ、TypeSafeの/v1/systemoneに対応する。Jevの非公開の重みを配布する製品ではなく、TypeSafe・Ollamaとは独立したプロジェクトだ。[1][2]

RUNTIME動かす仕組み

Ollaya
モデルの取得、起動、API、モデル切り替えを担当。

MODEL判断する中身

Laya / Kev / Decider
速度、言語、文脈長、得意な判断はモデルごとに違う。

APPLICATION仕事として使う仕組み

自分たちの業務アプリ
Teams取得、台帳、通知、権限、承認を担当。

入力は文章やJSONで表した状態と、事前に定義する質問。出力は説明文ではなく、選択肢・スコア・二値的な判定を表す型付きの値。「何を尋ねるか」をアプリ側が設計する必要がある。[1]

返金要求の検出 ≠ 返金の承認。
「返金してほしい」と分類できても、二重課金の事実や契約条件、実行者の権限が確認できたわけではない。

本号の業務例:問い合わせの種別、要確認候補、処理ルートを整理する。金銭の移動、本番変更、外部送信は、別のルールと承認で制御する。

出典:公式README [1] / TypeSafe互換仕様 [2]。3層の整理と返金の例は本号の解説。

COMMUNITY SIGNALS & EVIDENCE

Xの盛り上がりと、実務での品質を分けて読む

条件・限界に注意原投稿・利用報告・公開仕様は、証拠としての役割が違う

HNには、ローカルで分類モデルを扱いやすくした点への期待と、「分類技術そのものは以前からある」「具体的な業務でどこまで役立つのか」という慎重な議論が並ぶ。便利な製品化への関心と、判断精度の実証は同じではない。[4]

WHAT ATTRACTS ATTENTION評価される方向

モデルの取得と実行が短いコマンドで済む。既存のAPI形式を生かせる。クラウドに送らず、手元で比較しやすい。

製品の使いやすさに関する論点。大量運用の品質保証ではない。

WHAT REMAINS OPEN残っている疑問

業務固有の名前、長い前提、複雑な条件を扱えるか。速く分類しても、見逃しが増えるなら価値が下がる。

HN上の個々のコメントは、統制された性能比較ではない。

話題化・体験談・評価結果を混ぜない
材料読み取れることそこからは言えないこと
Xの反応数注目や拡散の大きさ正解率、安定性、日本語の業務適合
個人の少数テストその環境・その例での結果まれな失敗や本番の見逃し率
作者の公開評価記載された条件での性能すべての職場で同じ結果が出る保証
自社データの評価自分たちの対象業務への適合別業務・モデル更新後への無条件の適用

Xの細かい反応数・実測は本号の根拠に採用していない。
元の紹介にあった個別投稿のいいね・表示数や「97%削減」などは、原投稿と測定条件を独立に再確認できていない。虚偽と断定するのではなく、未検証として区別する。

出典:HN原スレッド [4] / 製品の操作体系は公式README [1]。評価材料の分類は本号の整理。

ACCURACY, LATENCY & TRAINING CONDITIONS

最速のLayaと、高精度モデルを同じものとして扱わない

公式仕様・公開資料条件・限界に注意作者掲載の測定値。独立実測・日本語の業務精度ではない

APIを統一できても、推論の中身は違う。小さいエンコーダ型は速さに、大きいモデルは判断品質に利点が出る場合がある。ランタイムの使いやすさと、モデルの強さを別々に評価する。[1][3]

typed-decisionsの掲載値と、RTX 4090上の5質問の速度
モデル掲載正解率処理時間読みどころ
通常のLaya約36%約8〜10ms速いが、難しい判断の品質は別
Decider 4B68.0%約520ms小型エンコーダより重い
Kev 9B72.2%約500ms公式は24GB GPUが必要と説明
Winnow E4B72.2%約89ms現行READMEの推奨候補
Jev(ホスト型)73.8%ここでは比較しないローカルと同一環境の測定ではない

小さい画面では表を横にスクロールできます。

出典の掲載値を2026/09/27に再確認。typed-decisionsは2,000質問。通常Layaの約36%は互換文書の記載、時間はモデル別の公式測定から整理しており、全列が同一の実験ログではない。Layaの8msと10msは多言語版/英語版の違いも含む。9/26時点の完全なスナップショットや、CPUでの速度保証ではない。[1][2][3]

BASE CHECKPOINT通常のLaya

約36%

typed-decisionsに、そのまま適用した場合の掲載値。導入直後の汎用性能と見る。

TASK-SPECIFIC FINE-TUNE専用の追加学習版

76.6%

laya:typed-decisionsの値。通常のLayaを入れるだけで得られる性能ではない。

追加学習版の高得点を、通常版の実力に置き換えない。
専用学習は有効な選択肢だが、比較対象・学習条件・評価データをそろえて読む必要がある。

出典:READMEのモデル表 [1] / 互換文書の品質上の違い [2] / FAQの速度・評価条件 [3]。

JAPANESE, CONTEXT & TRUNCATION

日本語対応より、「条件と訂正を落とさないか」

公式仕様・公開資料本号の解説・提案対応言語数は、業務上の正確さの保証ではない

laya:multilingualは100以上の言語を対象とし、layaは言語に応じて英語版と多言語版を選ぶ。日本語の検証では、利用するチェックポイントを明示して結果を残したい。[1]

NEGATION否定

「対応不要では
ありません」

「不要」の単語だけで、処理対象から落とさないか。

CONDITION条件付き

「承認します。
ただし反映は来週」

承認と、実行可能な時期を分離できるか。

CORRECTION訂正

「訂正です。
本日の反映は中止」

前の予定より、後の訂正を優先できるか。

長いスレッドは、最後まで読めたかも確認する

OLLAYA互換文書の掲載値Laya 英語版

512 tokens

質問と選択肢も含めた入力の制約。

OLLAYA互換文書の掲載値Laya 多言語版

1,024 tokens

Laya本体や別の実行形式の設定と混同しない。

2026/09/27再確認の互換文書では、入力が収まらない場合、/v1/*は422 STATE_TRUNCATEDを返す。一方、ネイティブの/api/decideは切り詰めとその情報を返す。呼び出し経路によって挙動が違う。[2]

本号の提案:スレッド全文ではなく、判断に必要な単位を作る。
対象発言、直前の関連発言、発言者、時刻、対象案件を整理する。収まらない・前提が不足する場合は「対応不要」ではなく「要確認」へ戻す。

出典:言語ルーターとモデルの区別 [1] / 入力長・切り詰めの仕様 [2]。日本語の例と入力整理は本号の提案。

CONFIDENCE IS NOT OBSERVED ACCURACY

confidence 0.9は、「9割正解する」という証明ではない

公式仕様・公開資料本号の解説・提案公開コードの計算式と、実業務での校正を分ける

TypeSafe互換出力のconfidenceは、最も高い選択肢のモデル確率を、選択肢数に応じて正規化した値。実際に何件正解したかを、その場で集計しているわけではない。[5]

confidence = (K × pmax − 1) ÷ (K − 1)K:選択肢数 / pmax:モデルが返した最大確率。実装では0〜1に収める。

確信度の計算を試す

モデル推論ではなく、式の説明用
TypeSafe互換の confidence0.70

例:3択で0.80 / 0.15 / 0.05なら、confidenceは0.70。これは「70%正解」の意味ではない。最大確率は1/K〜1が有効範囲。入力値の外部送信は行わない。

MODEL OUTPUT確率分布の集中

モデルが、ほかの選択肢よりどれだけ一つを選んでいるか。強く集中したまま、間違う可能性もある。

EMPIRICAL CALIBRATION実際の正答頻度

高い値を返した案件が、実データでは何割正しかったか。自分たちのラベル付きデータで確かめる。

「confidence ≥ 0.9なら自動承認」を初期設定にしない。
モデル・質問文・選択肢・言語を変えると、同じしきい値でも誤判定率は変わり得る。型が互換でも、安全性が同じとは限らない。

出典:Ollayaのanswer.rs(実装を固定コミットで参照) [5] / 自分のデータで校正するというFAQの注意 [3]。計算機と業務上の扱いは本号の解説。

WINDOWS & DEVELOPER EXPERIENCE

使い始めは短い。でも、URL変更だけでは終わらない

公式仕様・公開資料本号の解説・提案会社PCでは、導入許可と実機での動作確認が先

公式はWindows 10/11のx64環境、CPU実行、対応するNVIDIA GPUの利用を案内している。専用GPUがないPCはCPUを前提にし、普段のTeamsやブラウザーを開いた状態で測定する。[3]

会社PCで、未確認のインストールスクリプトを直接実行しない。
配布物、実行ファイル、PowerShell、モデルダウンロードが社内ルールに適合するかを先に確認する。下のコマンドは、承認済みの導入後の動作確認用。

① 日本語モデルを明示して試す

ollaya --version
ollaya pull laya:multilingual
ollaya run laya:multilingual --preset triage "決済が二重に行われました。重複分を返金してください。"
ollaya ps

② Jevクライアントの接続先を変更(PowerShell)

$env:TYPESAFE_BASE_URL = "http://127.0.0.1:11435"
$env:TYPESAFE_API_KEY = "local"
$env:TYPESAFE_DEFAULT_MODEL = "laya:multilingual"
$env:NO_PROXY = "localhost,127.0.0.1"

互換説明はTypeSafe Python SDK 0.7.1を対象としている。コード内でモデル名を固定している場合は、環境変数だけでは切り替わらない。サーバーでOLLAYA_API_KEYを設定した場合は、その値と一致するキーが必要。[2]

FIRST REQUEST初回だけ遅いことがある

SDKの既定タイムアウトは10秒。コールドロードの時間と、ロード済み状態の推論時間を分けて確認する。

MODEL & PROXYモデルと経路を確認

必要モデルは先に取得する。ローカル呼び出しをシステムのプロキシへ流さないよう、NO_PROXYも確認する。

MCP経由で接続する場合

公式の接続例はclaude mcp add ollaya -- ollaya mcp。ローカル推論でも、呼び出し元AIに渡す文章やツール結果までローカルに閉じるとは限らない。機密情報の経路全体を確認する。[1]

出典:公式CLI・モデル取得 [1] / SDK・キー・プロキシ・タイムアウト [2] / Windows対応 [3]。導入と評価の順番は本号の提案。

LOCAL PRIVACY & TOTAL COST

価値は「API無料」より、データの置き場所を選べること

公式仕様・公開資料条件・限界に注意費用と外部送信は、システム全体で見る

LOCAL INFERENCEローカルの価値

既定は127.0.0.1:11435。公式FAQは、推論をローカル実行し、状態と質問をログしないと説明する。

作者の仕様説明であり、本号が通信監査を実施した結果ではない。[3]

TOTAL COSTゼロではない費用

ローカル推論のAPI従量課金はない。一方で、端末・電力・モデル管理・更新・障害対応のコストは残る。

Ollaya本体はApache-2.0。利用するモデルのライセンスも別に確認する。[3]

比較対象のJevは、公式発表で入力100万トークン当たり0.042ドル、出力無課金と案内されている。小規模利用では、API料金の節約だけより、機密性・オフライン性・管理の自由度が導入理由になりやすい。[6]

ホスト型Jevの入力料金を試算

公開単価による単純計算 / USD
入力料金の概算$0.42

回数 × 入力トークン数 ÷ 1,000,000 × $0.042。質問も入力に含める。税・為替・通信・開発運用費を含まない。モデルの料金変更、実際の課金条件は利用時に確認。入力値の外部送信は行わない。[6]

「外に出さない」方針なら、不確実な案件も自動では外に送らない。
ローカルモデルが迷ったとき、クラウドJevや別のAIへ無条件に転送する構成は、その方針と両立しない。人間の確認を出口にする。

出典:ローカル動作・ライセンスの公式説明 [3] / TypeSafeの公表単価 [6]。総費用・外部送信経路の評価は本号の解説。

TEAMS WORKFLOW / DESIGN PROPOSAL

最初の実装は、「自動実行」ではなく「要対応候補の整理」

本号の解説・提案以下は実装済み機能ではなく、業務アプリへの組み込み案

Teams中心の仕事に取り込むなら、Ollayaを業務全体の判断主体にしない。元の文章と一緒に候補を示し、本人が確認して行動する構成から始める。誤分類を発見し、修正できる位置にモデルを置く。

STEP 01対象を取得

必要な発言と前後関係を、許可された方法で取得。

STEP 02ローカルで分類

依頼、質問、共有、承認依頼などの候補を返す。

STEP 03原文と提示

分類候補だけでなく、発言者・時刻・原文も表示。

STEP 04本人が行動

返信・承認・タスク登録は、本人が確認して実施。

↶ 誤分類と修正を残し、次回の評価データへ。モデルを自動更新するという意味ではない。

一つの選択問題に、同時成立する性質を混ぜない

「緊急」「承認待ち」「自分担当」は同時に成立する。これらを1問の排他的な選択肢にせず、別々の観点で質問を設計する。

質問を分けて、結果の使い道を明確にする
確認したいこと結果の使い道残す人間の判断
自分への対応依頼か要対応候補を抽出担当の最終確認
依頼・質問・共有のどれか受信内容を整理文脈不足の解消
期限・緊急性があるか確認順を提案他案件との優先順位
条件付き・訂正があるか確認が必要な箇所を示す正式な承認と実行の決定

分類で「対応不要」になっても、原文を見えなくしない。
最初から通知やメッセージを隠すと、誤分類が見逃しに直結する。未判定・エラーも確認対象として残す。

構成・質問設計・運用上の境界は本号の提案。モデルの型付きAPIは公式README [1] と互換仕様 [2] を参照。

ACCEPTANCE CRITERIA & NEXT ACTION

導入判断は、正解率より「見逃しが増えないか」

本号の解説・提案初期評価の例。件数だけで、まれな重大事故は保証できない

まずは人が正解ラベルを付けた200〜300件程度を用意し、現在のキーワード判定も含めて比較する。モデルに有利な例だけでなく、否定・条件・訂正・長文・曖昧な担当を入れる。質問調整に使ったデータと、最後の評価用データは分ける。

採否を決めるために記録すること
指標見る理由
要対応案件の見逃し「不要」への誤分類が、本来の仕事を失わせていないか。
不要な通知の量過剰な警告で、かえって重要な通知が埋もれていないか。
高確信度の誤り高い値を返した案件にも、危険な誤判定がないか。
通常時と遅い側の処理時間初回ロード、並行作業、長文でも業務を妨げないか。
エラー時の挙動切り詰めやタイムアウトが、無言の見逃しに変わらないか。

導入前チェック

このページを開いている間だけのチェック。保存・送信なし。0 / 6

最初の目標は、無料のJevではない。

会社PCの中で、要対応候補を整理し、人の見落としを減らす。
見逃しを増やさず、通知の質を上げられたときに、採用する意味が生まれる。

評価計画・チェック項目・採用方針は本号の提案。公式も本番の切り替え前に自分のデータで測定するよう注意している。[2]

PRIMARY SOURCES & EDITORIAL NOTES

出典と、今回の確認範囲

  1. Ollaya — 公式README(固定コミット) ↗実行基盤、CLI、モデル一覧、言語ルーター、MCP、公開評価。参照版:6d121dd。
  2. Ollaya — TypeSafe compatibility ↗SDK 0.7.1、環境変数、APIキー、タイムアウト、文脈長、STATE_TRUNCATED、通常版と追加学習版の違い。現行文書。
  3. Ollaya — FAQ ↗モデルごとの掲載速度・精度、Windows/CPU/GPU、プライバシーの説明、校正、ライセンス。作者の説明・測定であり本号の実機検証ではない。
  4. Hacker News — Ollaya / Ollama for open-source, Jev-style decision models ↗コミュニティの議論。個人の意見・利用談を、統制されたベンチマークとは区別。反応数は変動するため本号では固定しない。
  5. Ollaya — confidenceの公開実装(answer.rs) ↗TypeSafe互換の正規化式:(K × pmax − 1) / (K − 1)。Laya固有のエントロピー型確信度とは別。
  6. TypeSafe AI — Introducing System One Models & Jev ↗Jevの位置づけと公表単価。入力$0.042 / 100万トークン、出力無課金。料金の試算はこの掲載値を使用。
  7. VisionHub — 2026年9月12日号(デザイン参照) ↗配色・表紙・要点カード・1枚ボード・章ナビ・SO WHAT・出典の構成を踏襲。本号の内容の根拠には使用しない。
編集上の注記
号数は No.422(暫定)。09/25号が後から入ると421となり、本号番号が繰り下がる可能性がある。
2026/09/26号として、2026/09/27に再確認した一次情報で編集。現行ドキュメントは更新されるため、同日時点の公開版を完全に復元した資料ではありません。Xの原投稿の細かい反応数や個人の少数テストは、独立確認ができていないため性能根拠から除外しました。数値は作者掲載値と本号の計算例を区別し、一般的な日本語業務の正解率には読み替えていません。
このHTMLは外部スクリプト・外部フォント・外部画像を読み込みません。計算機は式の説明用で、モデルの実行やネットワーク送信は行いません。出典リンクを開く操作は外部サイトへの移動になります。