WHAT HAPPENED
圧縮が、配置の解禁になった
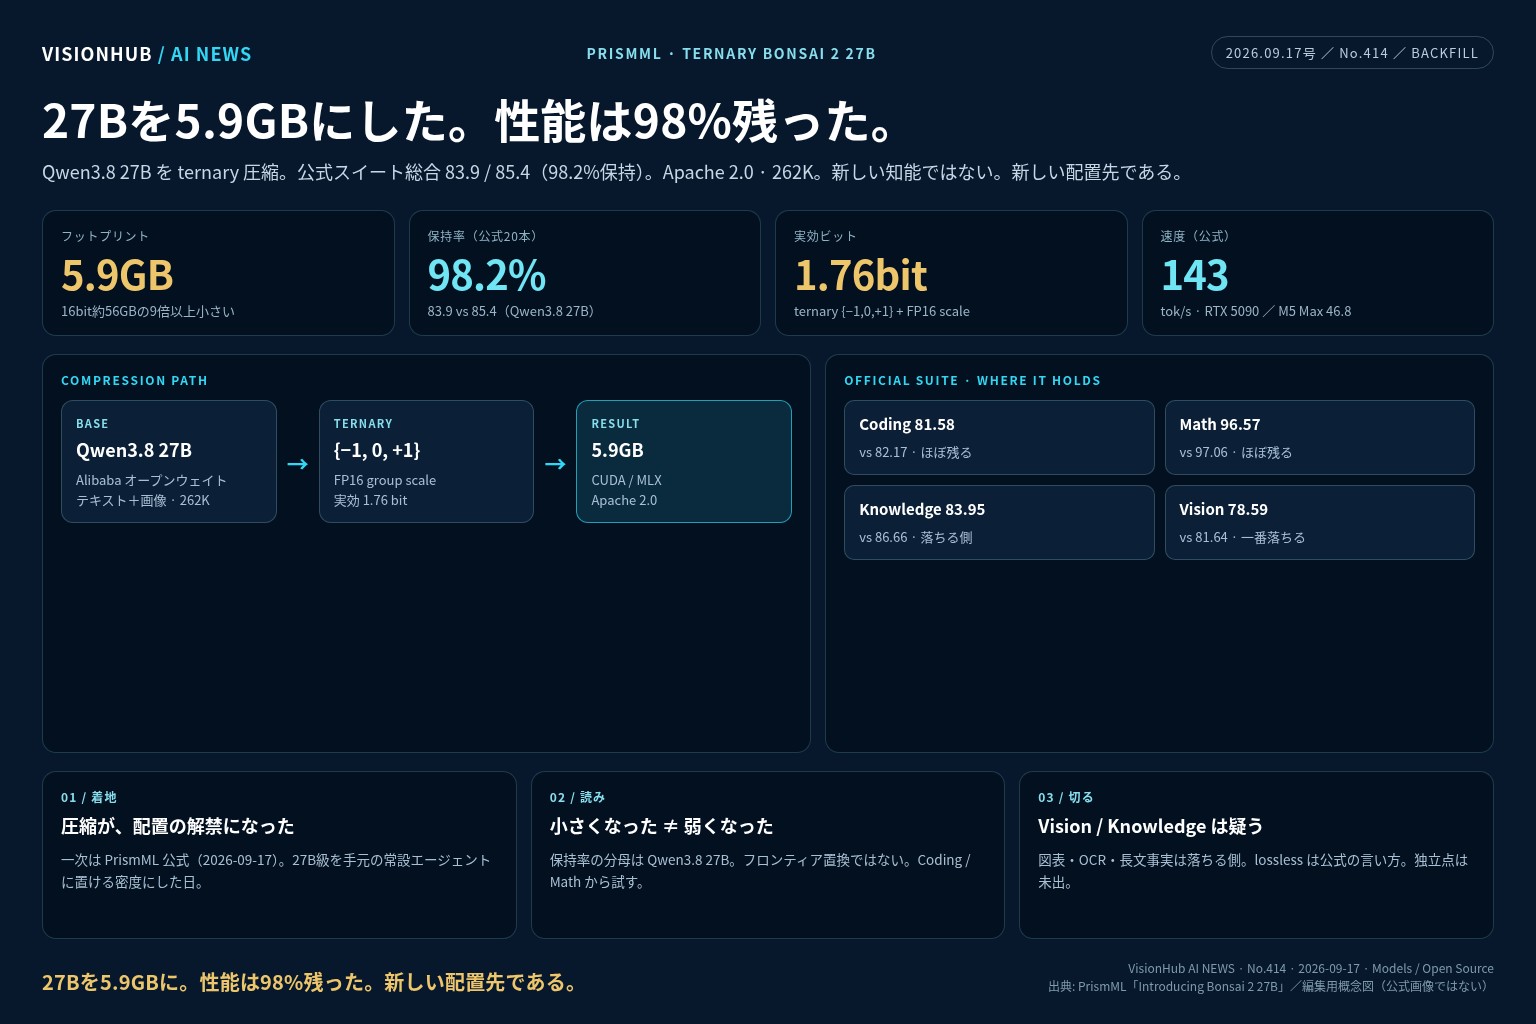
一次は PrismML 公式ブログ。日付は 2026-09-17。同日のプレス稿は PASADENA, Calif. — September 17, 2026。対象は新アーキテクチャの発明ではない。既にある 27B を、手元で回せる大きさにした。
09/17の一次は公式。小さくしたのは重み。残したのは仕事の形
ベースQwen3.8 27B
Alibaba のオープンウェイト。テキストと画像。262K。
フル精度は公式の対比で約56GB。
Bonsai 2 はこれを ternary で切る。
結果5.9GB に落ちた
重みは {−1, 0, +1}。FP16 のグループスケール。
実効 1.76 bit。言語モデル側を端から端まで低ビットにした、と公式は書く。
ライセンスは Apache 2.0。
CUDA は NVIDIA GPU。MLX は Mac / iPhone / iPad。公式はカスタム低ビットカーネルを使う、と書く。1-bit 版は 3.9GB で iPhone 17 Pro を例に出している。今日の本命は ternary の 5.9GB 側である。
- 会社は Caltech 系。seed は公式・TechCrunch とも $22.25M。出資に Khosla Ventures、Cerberus、Google、Samsung
- CEO は圧縮研究者 Babak Hassibi。TechCrunch は Apple との協議観測に触れ、本人はコメントを拒んだ、と書く
- 初代 Bonsai 27B は 2026-07。保持率 95%。公式は「今回で 95% から 98%超へ穴を埋めた」と書く
BROKEN ASSUMPTION
「量子化は、必ず仕事を捨てる」ではない
混ざるな。表はメモリが9分の1になった。裏は、コーディングとツール呼び出しがほぼ残った、という公式の主張である。新しい天才モデルではない。同じ表の知能を、より多くの機械に載せた。
小さくなった ≠ 弱くなった。公式が先に「配置の解禁」と書いている
表フットプリント
5.9GB。RTX 級で 143 tok/s。
M5 Max で 46.8 tok/s。
4090 で 0.714 mWh/token。
全精度8Bより約40%省エネ、と公式は書く。
裏仕事の形
公式スイート総合。Coding 81.58 vs 82.17。
Agentic 77.57 vs 79.74。
Math 96.57 vs 97.06。
落ちているのは知識と視覚。
× 「フロンティアを超えた」とは書くな
公式自身が先に置く欠落はこれだ。低ビットの多くは、コーディング・視覚・エージェントのツール呼び出しを捨てて初めて置ける。Bonsai 2 は「そこを残した」と主張する。残した相手は Qwen3.8 27B であって、GPT-6 Astra や Fable 5.1 ではない。
OFFICIAL NUMBERS
公式が出した差。足さない
置ける数字は公式ブログにあるものだけ。星の数もダウンロード数も、09/17ブログには無い。ここには置かない。ベンチは公式の20本スイートである。
| 能力 | Bonsai 2 27B | Qwen3.8 27B | 読み |
|---|---|---|---|
| 総合 | 83.9 | 85.4 | 保持率 98.2%。公式の言い方 |
| Coding | 81.58 | 82.17 | HumanEval+ / LiveCodeBench v6 / MBPP+ / BigCodeBench |
| Agentic & Tool | 77.57 | 79.74 | τ²-bench / BFCLv3。約2点落ち |
| Math | 96.57 | 97.06 | AIME 2026 / 2025 / GSM8K / MATH-500 |
| Instruction | 82.66 | 81.25 | IFBench / IFEval。圧縮側が上回る |
| Knowledge | 83.95 | 86.66 | MMLU-Redux / GPQA Diamond / AA-LCR。落ちる側 |
| Vision | 78.59 | 81.64 | CharXiv ほか。一番はっきり落ちる |
| 文脈 | 262K | テキスト+画像入力 | |
| 速度 | 5090 143 / M5 Max 46.8 tok/s | 公式実測。独立点ではない | |
| 電力 | 4090 0.714 mWh/token | 全精度8Bより約40%省エネ、と公式 | |
| ライセンス | Apache 2.0 | 重み公開。CUDA と MLX | |
- Qwen3.6 27B の公式総合は 83.6。Bonsai 2 の 83.9 は、ひとつ前の世代のフル精度を総合で超える、という対比である
- 詳細の個別ベンチは公式がホワイトペーパーに送っている。この表は公開ページの集計だけを残す
- 重みの入口は Hugging Face の prism-ml / Bonsai-2 コレクション。GGUF と MLX が並ぶ
置かない: 初代の累計ダウンロード、Xのview、Appleとの協議、他社フロンティアとの勝敗、Artificial Analysis の未出独立点、「lossless」を検証済みのように書くこと。
LIMITS / NEXT-DAY
公式が自分で置いた限界。翌日の動きは3つ
5.9GBは新しい知能ではない。新しい配置先である
測っていない独立点は未出
数字は公式の20本スイート。
Artificial Analysis の公開点は、この原稿の時点で無い。
エージェントハーネスで崩れた、という現場の声は公式ページに無い。二次として分ける。
残る緊張相手は27B
保持率の分母は Qwen3.8 27B。
クラウドの最前線を置き換える話ではない。
ローカルの常設ループに、27B級を載せる話である。
公式は「 practically lossless 」と書く。総合の比である。Vision は 78.59 vs 81.64。Agentic は 77.57 vs 79.74。捨てていない、と「全く同じ」は別物である。
新規同じ箱で、同じ質問を
- MLX は stock で試せる。GGUF は PrismML-Eng/llama.cpp(prism-b10658 以降)が必要、とドキュメント側
- 手元のコーディング質問を、量子化 Qwen3.8 と比較する
- 公式の 98% が、自分のタスクで残るかだけ見る
既存クラウドを全部やめない
- 毎回出す判断を Bonsai に寄せる
- 難しいときだけ Frontier に上げる
- レイテンシと月額を、置き換え率と一緒に測る
運用視覚と知識を先に疑う
- 図表・OCR・長文事実は落ちる側
- そこを本務にするなら、5.9GBの話ではない
- コーディングとツール呼び出しから試す
FOR ENGINEERS
エンジニア向け示唆・どう切るか
- 一次は公式ブログ — 2026-09-17。題は Introducing Bonsai 2 27B。二次要約のダウンロード数は使わない
- 表は 5.9GB — ternary 1.76bit。CUDA と MLX。Apache 2.0。262K
- 裏は 98.2% — 分母は Qwen3.8 27B。Coding と Math はほぼ残る。Vision と Knowledge は落ちる
- 速度は 143 / 46.8 tok/s — 5090 と M5 Max。公式実測。独立点ではない
- 初代からの差は 95% → 98.2% — 公式が先に置いた対比。今回の本題は品質の穴埋め
- 次に試すなら1本の小さい仕事 — 同じプロンプト比較、ルーティング、視覚タスクは後回し。3つを混ぜない
注意: 「27Bがフロンティアを超えた」とは書かない。公式は Qwen3.8 27B との比だけを出している。出したものは、同じ表の知能を、手元の常設エージェントに置ける密度である。lossless は公式の宣伝語。GGUF を stock llama.cpp の Q2_0 として読むな。ドキュメントは PrismML の fork を先に置く。検証は使う側の仕事である。
TAKEAWAY
27Bを5.9GBにした。性能は98%残った。新しい知能ではない。新しい配置先である。
一次:PrismML “Introducing Bonsai 2 27B”(2026-09-17)|Day Slide No.414